一场持续三十多年的「长期主义 + 软硬件协同」 面向普通读者的中文历史梳理 | 含时间线、关键决策、数据与来源 | 资料截止:2026-09-17
先说结论:英伟达不是突然押中了 AI
英伟达的崛起可以概括为四次连续押注:先用 3D 图形芯片切入 PC 游戏市场;再把 GPU 做成可编程的并行计算器;随后用 CUDA、软件库和开发者生态把芯片变成平台;最后补齐网络、CPU、系统和云服务,把「显卡公司」升级为数据中心基础设施公司。AI 热潮是放大器,不是故事的起点。[1][3]
💡 一句话看懂:英伟达真正的护城河不是单独某一代 GPU,而是「GPU + CUDA 软件栈 + 开发者生态 + 网络与系统 + 云厂商渠道」的组合。
这份文档怎么读
- 主线:1993 年创立 → 1995 年首款产品失利 → 1997 年 RIVA 128 翻身 → 1999 年 GeForce 定义 GPU → 2006 年 CUDA 铺路 → 2012 年 AlexNet 引爆 AI → 2020 年 Mellanox 补齐网络 → 2023—2025 年进入全栈 AI 基础设施。
- 证据分层:SEC 年报与 NVIDIA 官方材料用于时间线、产品和财务事实;Computer History Museum、Sequoia 访谈和技术论文用于补充创始人叙述与技术背景。
- 注意:公司年报包含企业自述和前瞻性表达;本文把公司自己的判断标成「公司称/年报称」,不把宣传口号当作独立审计结论。
一张图看懂三十多年转向
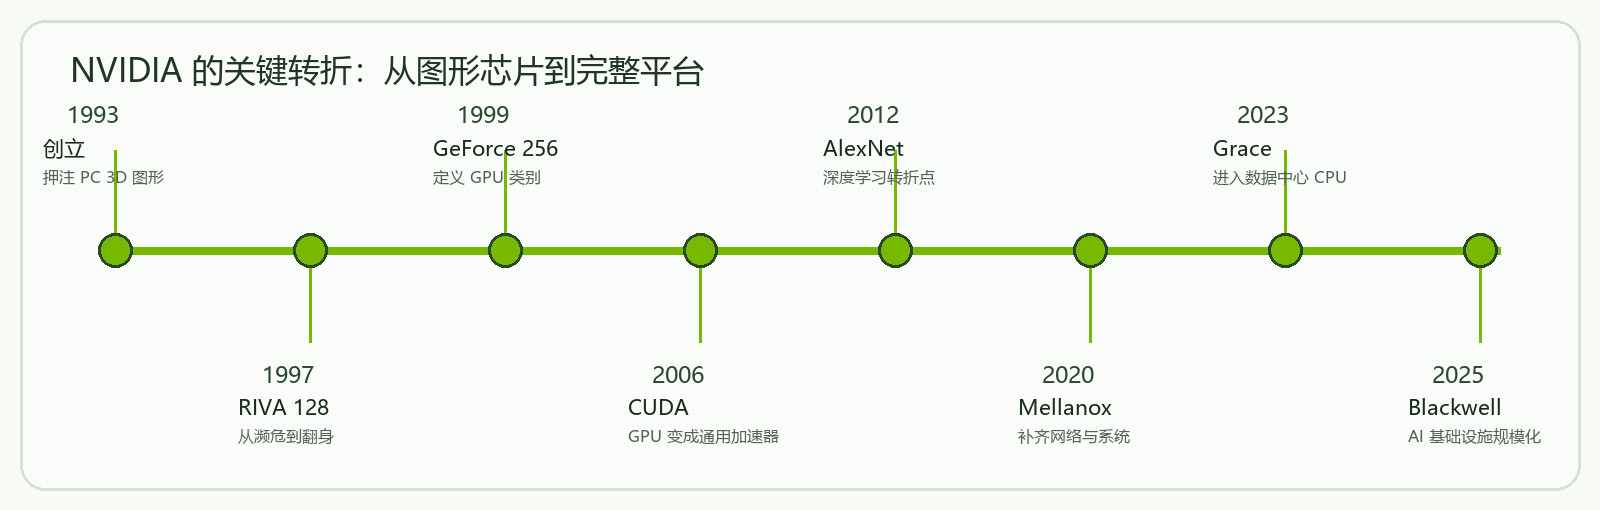
图 1|从 3D 图形到 AI 基础设施的关键节点(根据 [1][3][10] 及各章节来源整理)
一、1993—1995:在 PC 3D 图形的缝隙里创业
1993 年,Jensen Huang(黄仁勋)、Chris Malachowsky 和 Curtis Priem 创立 NVIDIA。三位创始人都具备芯片、系统或图形工程背景,他们判断 PC 不会只用来处理文档,3D 图形和互动娱乐会成为下一轮计算平台。[1][2]
这个判断今天看起来顺理成章,但当时并不容易。创业公司既没有英特尔那样的制造能力,也没有成熟的产品渠道,最现实的办法是做一家「无晶圆厂」芯片公司:自己设计芯片,把制造交给代工厂,再通过显卡板卡厂商和 OEM 厂商进入市场。
NVIDIA 的第一款重要产品是 1995 年推出的 NV1 多媒体处理器。它把 2D、3D、视频、音频和游戏接口集中到一块芯片上,但采用了与行业主流不同的曲面/二次曲面路线。随后 Microsoft 的 DirectX 生态更坚定地转向三角形图元,这让 NV1 的技术选择陷入被动。[1][4]
⚠️ 第一次教训:技术上「很酷」不等于生态上「可用」 NV1 的失败不是因为 NVIDIA 没有工程能力,而是因为它押错了接口和开发者生态。后来 NVIDIA 对 RIVA 128 的修正,本质上是回到行业标准、优先解决客户能不能用的问题。
二、1995—1997:濒临倒闭时,靠 RIVA 128 翻身
NV1 失利后,公司资源迅速收缩。关于这一段,Jensen Huang 在后来的访谈中反复讲过一个版本:NVIDIA 曾经距离现金耗尽非常近,Sega 的支持给了公司继续开发下一代产品的时间。[4] 这是创始人回忆,不应被当作审计过的「剩余现金天数」;但它准确揭示了当时的风险程度。
NVIDIA 随后放弃 NV1 的曲面路线,转向兼容 Direct3D 的三角形图形架构,做出了 RIVA 128。1998 年的 NVIDIA 历史新闻稿称,RIVA 128 在上市不到四个月内出货超过一百万颗,并获得大量 OEM 和板卡厂商采用。[8] 这次转向把公司从「有想法但没市场」的状态,拉回到主流 PC 图形市场。
| 阶段 | 错误/选择 | 结果 |
|---|---|---|
| NV1 | 坚持非主流的曲面图元路线 | 与 DirectX 生态错位,产品失利 |
| RIVA 128 | 改用三角形图元,兼容主流 API | 快速获得 OEM 与板卡厂商采用 |
| 组织层面 | 在危机中集中资源,不再分散战线 | 把有限现金押在一颗关键芯片上 |
RIVA 128 的意义不只是一款销量不错的显卡:它让 NVIDIA 形成了一个后来不断重复的能力——快速吸收失败、重新选择标准、把产品做成可规模化的平台组件。
三、1999—2005:GeForce 把「显卡」变成 GPU 类别
1999 年,NVIDIA 推出 GeForce 256,并把它定义为「GPU」(Graphics Processing Unit)。NVIDIA 后来的年报把这一产品视为 GPU 时代的起点:GPU 不再只是显示像素的附件,而是负责一部分几何、光照和并行图形计算的专用处理器。[1][3]
同年 NVIDIA 上市。上市本身不是技术突破,但它给了公司更稳定的融资和研发能力,使 NVIDIA 能以较快节奏迭代芯片、驱动和开发工具。接下来的竞争不只是「谁的显卡跑分高」,还包括谁能让游戏开发者、操作系统和板卡厂商更快采用自己的架构。
- 产品层:不断提高图形处理能力,把 GPU 变成 PC 游戏和专业图形的核心计算单元。
- 生态层:围绕 DirectX、OpenGL、驱动和开发者工具做兼容与优化。
- 商业层:通过芯片设计、板卡伙伴和 OEM 渠道扩大出货,而不是自己承担全部制造和渠道。
这一阶段的关键不是某一张显卡,而是 NVIDIA 逐渐掌握了「芯片架构—驱动—开发者—游戏厂商—OEM」这条链路。后来 CUDA 能够建立生态,和这段图形生态积累直接相关。
四、2006—2011:CUDA 是最重要、也最容易被忽略的转折
2006 年,NVIDIA 发布 CUDA,把 GPU 的大量并行计算能力开放给图形以外的应用。官方发布信息把 CUDA 描述为一种新的 GPU 计算架构,并配套提供面向 GPU 的 C 编译器和开发环境。[5]
这一步的难点在于:游戏显卡已经有市场,但「让科研人员、工程师和企业把 GPU 当通用计算器」在当时并没有现成的大众需求。NVIDIA 需要同时做硬件、驱动、编译器、数学库、示例代码、培训和开发者支持。也就是说,它主动把卖一块芯片的问题,升级成了建设一套编程平台的问题。
🎯 真正的长期下注:如果 NVIDIA 只把 GPU 当作游戏显卡,它的天花板会受限于 PC 游戏周期;CUDA 让 GPU 进入科学计算、金融、医疗、渲染和机器学习,也让后来的 AI 需求可以直接调用既有基础设施。
为什么 CUDA 比单纯的硬件领先更重要?
- 迁移成本:开发者把代码、模型、库和部署流程建立在 CUDA 上后,不会轻易换平台。
- 规模效应:开发者越多,NVIDIA 越有动力维护库和工具;软件越完整,客户越愿意买 NVIDIA 硬件。
- 应用扩展:同一套 GPU 可以服务游戏、科研、高性能计算、深度学习和生成式 AI。
五、2012:AlexNet 让 GPU 与深度学习相遇
2012 年,Alex Krizhevsky、Ilya Sutskever 和 Geoffrey Hinton 的卷积神经网络在 ImageNet 图像识别竞赛中取得突破性成绩,论文明确写到模型使用了两块 GTX 580 GPU 训练。[7] NVIDIA 的 2025 年 10-K 则把这件事称为 AI 的「Big Bang moment」,并强调 AlexNet 是在 NVIDIA GPU 上训练的。[3]
更准确的说法是:AlexNet 并不是 NVIDIA 单独「发明」的,神经网络算法、数据集、训练方法和 GPU 计算共同促成了突破。但 NVIDIA 之前已经把硬件和 CUDA 软件栈准备好,因此当深度学习需要大规模并行计算时,它成为最容易被研究者采用的平台之一。
| 时间 | 外部变化 | NVIDIA 已经准备好的东西 |
|---|---|---|
| 2006 | GPU 计算开始走出图形领域 | CUDA、编译器、开发者工具 |
| 2012 | 深度神经网络在视觉任务上突破 | GPU 并行计算 + CUDA 生态 |
| 2017 | AI 计算需要更专用的矩阵能力 | Tensor Core GPU |
| 2023—2025 | 生成式 AI 需要数据中心规模的训练与推理 | Hopper/Blackwell、网络、CPU、系统与软件 |
这就是英伟达故事里最容易被忽视的时间差:大众在 2023 年 ChatGPT 之后才普遍注意到 AI 算力,但 NVIDIA 已经为这类需求准备了十多年。
六、2017—2022:从 GPU 芯片走向数据中心系统
NVIDIA 不是只把消费级 GPU 换个名字卖给数据中心。公司逐渐推出面向 AI 的 Tensor Core GPU,建设 DGX 等系统,并围绕训练、推理、科学计算和企业部署开发软件。NVIDIA 2025 年 10-K 的自述显示,截至 FY2025,公司提供的不仅是 GPU,还包括 CPU、DPU、互联、系统、软件和服务。[3]
2020 年完成对 Mellanox 的收购,是这一过程中的关键一步。NVIDIA 官方新闻稿将其定位为把计算与高速网络结合起来,以推动下一代数据中心。[6] 对 AI 集群而言,GPU 算力再强,如果 GPU 之间、服务器之间的通信跟不上,整体训练效率仍会受限;网络因此从「配件」变成系统性能的一部分。
- GPU:负责大规模并行计算和神经网络训练/推理。
- CPU:负责通用控制、数据准备和系统管理;2023 年推出 Grace 数据中心 CPU。[3]
- DPU/网络:处理数据搬运、存储、安全与服务器间通信。
- 软件:CUDA、数学库、训练/推理工具、企业 AI 软件和云服务。
这一步改变了客户关系:客户购买的不再只是一块插卡,而是一套可以部署在云端或自有机房的加速计算平台。
七、2023—2025:生成式 AI 把长期布局变成大规模收入
生成式 AI 和大语言模型的普及,迅速放大了对训练和推理基础设施的需求。NVIDIA 在 FY2025 年报中披露:公司全年收入为 1305 亿美元,数据中心收入为 1152 亿美元;这些数字属于 NVIDIA 报告的财务年度,不等同于自然年 2025,也不代表未来必然延续。[10]
2024 年 NVIDIA 发布 Blackwell 平台,官方新闻稿把它定位为面向大规模生成式 AI 的新一代计算平台。[9] 到 FY2025,NVIDIA 的叙事已经从「GPU 供应商」变成「数据中心级计算基础设施提供商」,包括 GPU、CPU、DPU、互联、服务器系统、软件和云服务。[3][10]
🏭 规模化的本质:AI 模型越大,客户越关心整套系统的吞吐、能耗、网络通信、软件兼容、部署速度和供应能力。英伟达的优势因此从单点芯片性能,扩展到整个平台的交付能力。
八、英伟达为什么能发家?五个关键原因
- 选对长期问题:它没有只追逐某一代游戏画面,而是持续押注「并行计算会越来越重要」。3D 图形、科学计算、深度学习和生成式 AI 看似不同,底层都需要大量并行运算。
- 失败后快速改方向:NV1 的路线失误没有被包装成成功,NVIDIA 改用主流三角形图元,做出 RIVA 128。创业公司真正稀缺的不是永远正确,而是有能力在现金耗尽前完成方向切换。
- 把硬件变成软件平台:CUDA 让 GPU 不再只服务游戏开发者,而是成为科研、工程和 AI 开发者的平台。软件生态带来迁移成本和网络效应。
- 提前建设 AI 所需的底层能力:Tensor Core、CUDA 库、DGX、网络互联和数据中心系统,都是在生成式 AI 爆发前逐步铺设的。
- 从芯片卖到整套系统:通过 Mellanox、Grace、DPU、互联、企业软件和云服务,NVIDIA 能够优化从芯片到集群的多个层级,而不是只等待板卡订单。
九、这段历史不能只讲成「天才和运气」
英伟达的成功故事很容易被简化为「黄仁勋眼光太准」。这种讲法忽略了风险、失败和外部条件。更完整的理解应该包括以下限制:
- 依赖供应链:NVIDIA 采用无晶圆厂模式,制造、封装、先进制程和高带宽存储等环节依赖外部供应商。[3]
- 需求可能波动:AI 数据中心需求很强,但产品换代快、客户采购周期长,年报也提示需求估计和供应承诺存在不确定性。[3]
- 竞争不会消失:AMD、英特尔、云厂商自研芯片以及开源软件都可能改变竞争格局。
- 出口和监管:NVIDIA 年报披露,美国对部分高性能计算产品存在出口许可和限制,政策变化会影响市场和产品设计。[3]
- 公司叙事有选择性:官方材料擅长讲清战略主线,但对于失败项目、客户集中度和长期风险,仍应以 SEC 风险因素和独立资料交叉验证。
因此,英伟达的发家史不是「永远押中风口」,而是「在多次技术路线、市场周期和现金压力下,持续把下一次计算范式的基础设施提前做出来」。
十、把英伟达故事讲给别人听:3 分钟版本
- 英伟达 1993 年由黄仁勋、Chris Malachowsky 和 Curtis Priem 创立,最初押注的是 PC 3D 图形。
- 第一款产品 NV1 由于技术路线与 DirectX 生态错位而失败,公司一度陷入生存危机。
- 1997 年 RIVA 128 改用主流三角形图元,帮助公司翻身;1999 年 GeForce 256 把 GPU 这个类别推向市场。
- 2006 年 CUDA 把 GPU 变成通用并行计算平台。2012 年 AlexNet 在 NVIDIA GPU 上训练成功,深度学习进入新阶段。
- 此后 NVIDIA 不只做芯片,还做 CUDA 软件、Tensor Core、DGX、网络、CPU、DPU 和云服务。生成式 AI 爆发时,客户购买的是一整套 AI 基础设施。
- 所以它的核心竞争力不是一夜之间出现的,而是二十多年持续投入换来的平台效应。
附录:几个概念用大白话解释
| 概念 | 大白话解释 | 在英伟达故事中的位置 |
|---|---|---|
| GPU | 擅长同时做大量相似计算的处理器 | 最初服务 3D 图形,后来服务 AI |
| CUDA | 让程序员可以用 NVIDIA GPU 做图形以外计算的软件平台 | 把硬件优势变成生态优势 |
| Tensor Core | 专门加速矩阵/张量运算的硬件单元 | 针对深度学习训练和推理优化 |
| DPU | 专门处理数据中心网络、存储和安全任务的处理器 | 让 CPU/GPU 不必承担全部数据搬运 |
| 数据中心级平台 | GPU、CPU、网络、系统、软件和服务的组合 | 生成式 AI 时代的主要产品形态 |
资料与来源
以下来源按用途分层。官方年报和新闻稿用于产品、时间线与财务事实;技术论文用于 AlexNet;访谈和博物馆资料用于补充创始人和早期创业叙事。网页内容会更新,访问时间以本文生成日为准。
- [1] NVIDIA Corporate Timeline——NVIDIA 官方公司时间线;用于创立、GPU、GeForce 等节点。https://www.nvidia.com/en-us/about-nvidia/corporate-timeline/
- [2] Computer History Museum — Jensen Huang——计算机历史博物馆人物资料;用于创始人背景与公司早期叙事。https://computerhistory.org/profile/jensen-huang/
- [3] NVIDIA Corporation, Form 10-K for fiscal year 2025——SEC 原始申报;用于 CUDA、AlexNet、Tensor Core、Mellanox、Grace、Blackwell 和风险因素。https://www.sec.gov/Archives/edgar/data/1045810/000104581025000023/nvda-20250126.htm
- [4] Sequoia Capital — Crucible Moments: NVIDIA——投资机构访谈;用于 NV1 失败、Sega 支持和 RIVA 128 危机叙述;相关内容属于访谈回忆。https://sequoiacap.com/podcast/crucible-moments-nvidia
- [5] NVIDIA Unveils CUDA — The GPU Computing Revolution Begins——NVIDIA 2006 年 CUDA 发布材料的网页存档。https://web.archive.org/web/20200703112618/http://www.nvidia.com/object/IO_37226.html
- [6] NVIDIA Completes Acquisition of Mellanox——NVIDIA 官方新闻稿;用于 2020 年网络与数据中心战略。https://nvidianews.nvidia.com/news/nvidia-completes-acquisition-of-mellanox-creating-major-force-driving-next-gen-data-centers
- [7] ImageNet Classification with Deep Convolutional Neural Networks——NIPS 2012 论文;用于 AlexNet 使用 GPU 的技术依据。https://papers.nips.cc/paper_files/paper/2012/hash/c399862d3b9d6b76c8436e924a68c45b-Abstract.html
- [8] NVIDIA Ships Over One Million RIVA 128 Chips——NVIDIA 历史新闻稿网页存档;用于 RIVA 128 的出货与市场转折。https://web.archive.org/web/20110326212747/http://www.nvidia.com/object/IO_20020114_4455.html
- [9] NVIDIA Announces Financial Results for Q1 FY2025——NVIDIA 官方新闻稿;用于 Blackwell 平台与生成式 AI 基础设施叙述。https://investor.nvidia.com/news/press-release-details/2024/NVIDIA-Announces-Financial-Results-for-First-Quarter-Fiscal-2025/default.aspx
- [10] NVIDIA 2025 Annual Report——NVIDIA FY2025 年报;用于收入与数据中心收入数字。https://s201.q4cdn.com/141608511/files/doc_financials/2025/annual/NVIDIA-2025-Annual-Report.pdf
阅读边界:本文是一份历史与商业技术梳理,不构成股票投资建议。财务数字来自公司年报;估值、股价和未来预测没有纳入正文,避免把市场价格波动误写成企业历史事实。