三条线,一套方法:把标准写下来,把重复交出去,把判断留给自己。 这篇不讲工具怎么装,只讲我现在真正在跑的三套流程,以及它们各自的坑。
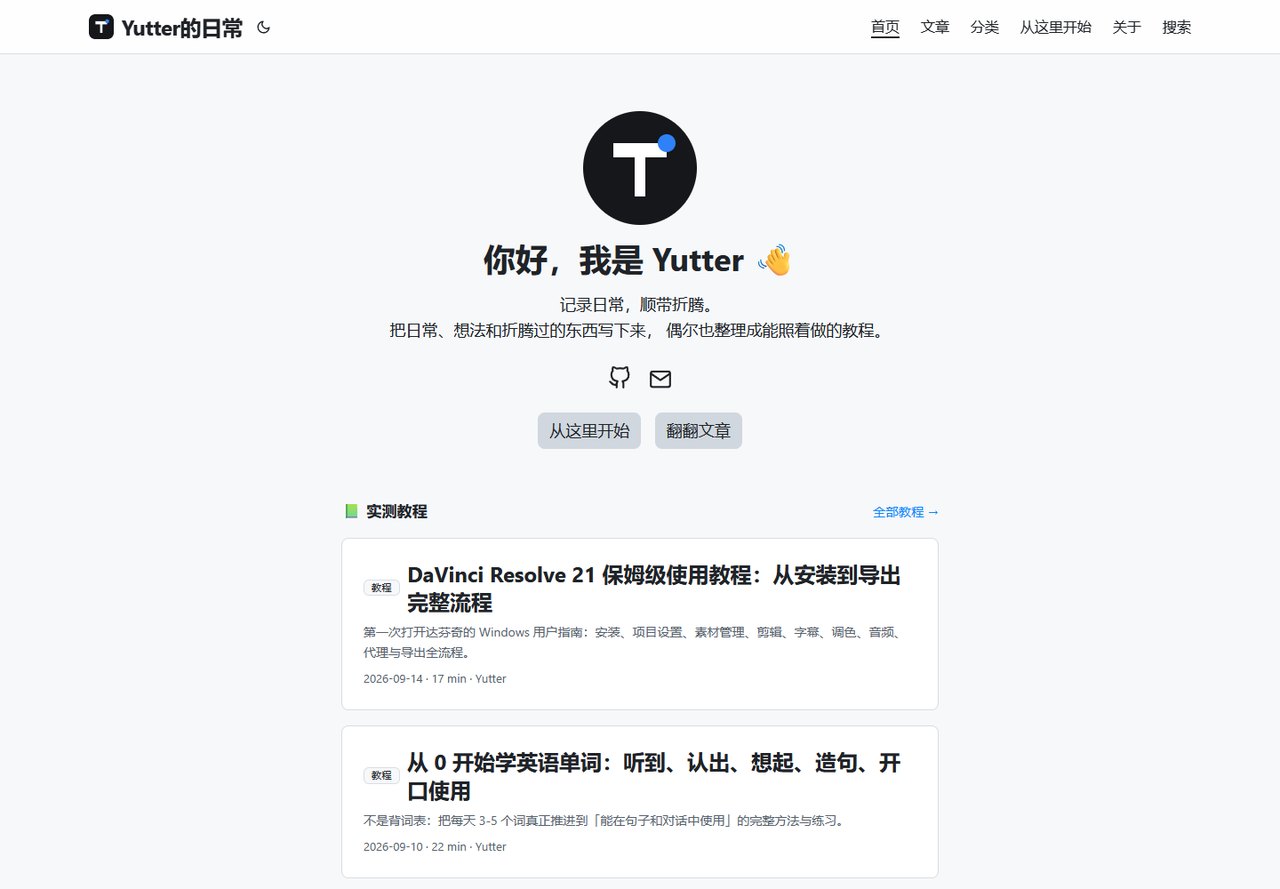 图 1|「Yutter的日常」:Hugo + PaperMod,部署在 Cloudflare Pages
一、先说说为什么
我做的事很杂:写博客、做 AI 科普视频、做海报,偶尔还折腾域名和服务器。
这些事有一个共同点——重复的部分特别多:排版、导图、压图、字幕、封面、发布清单。每一次都手工做,时间就全耗在这些"看不见的活儿"上。
所以我的做法是:把每一类工作的标准写成文档,交给 AI 照着执行;我只保留三件事——选题、审美、最终拍板。
二、生产线一:博客
流程
素材整理 → 写正文 → 套排版标准 → 本地构建 → 推送 → 自动上线。
- 站点:Hugo + PaperMod,部署在 Cloudflare Pages,推送到
main约 1 分钟自动上线 - 排版标准是固定的一套:字号、行高、段落间距、可折叠目录、图注格式、类型徽章
- 图片统一进
static/images/<文章名>/,正文用相对路径引用
性能这件事
博客不需要花哨,但必须快:
| 优化 | 数值 |
|---|---|
| 文章配图压缩 | 19 张图 3.9MB → 1.9MB(-52%) |
| 样式 / 脚本缓存 | 文件名带指纹,1 年 immutable |
| 文章配图缓存 | 30 天 |
| 传输 | Brotli 压缩 + HTTP/3 |
| 构建时间 | 1–2 秒 |
自动化
- 文章索引不用手写:推送文章后,仓库里的 Action 会重新生成 README 里的目录
- 构建失败会直接体现在部署状态里,推送后看一眼就知道有没有问题
三、生产线二:视频
视频有两条线,差别很大:
长视频(3–5 分钟科普)
流程固定成八步:选题 → 研究 → 剧本 → 分镜 → 生成素材 → 配音与字幕 → 合成 → 质检。
- 剧本按 4.9 字/秒 估算时长(中文 TTS 的实测值),先定时长再写内容
- 分镜每张卡只写一件事:谁、做什么、镜头怎么动
- 画面用本地模型生成 8–10 个镜头,动效层单独做
- 字幕必须用 Whisper 词级对齐——按字数估算会越到后面越错
- 合成后必须
ffprobe核对时长(设计 ±0.1 秒)
短视频(15–30 秒竖屏)
另一套逻辑:豆包生成 4–8 个镜头 → 裁切、去水印 → 字卡 → BGM → 混音。
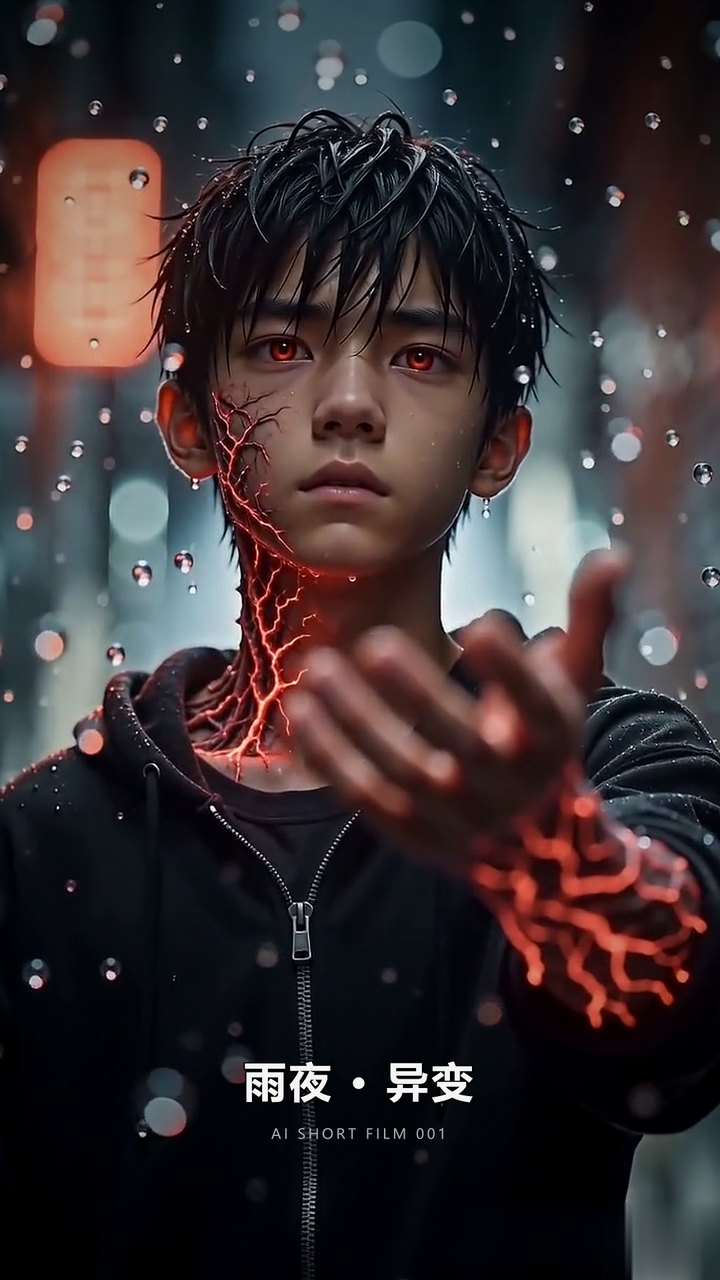 图 2|16 秒竖屏实验《雨夜 · 异变》——4 个镜头、2 张字卡
质检清单
- 抽帧看画面(尤其手和脸,缩略图看不清的细节最容易翻车)
- 字幕抽点核对(每段的句切换处都要看)
ffprobe核对总时长- 响度统一到 -16 LUFS
四、生产线三:海报
流程只有一句话:AI 画画面,HTML 排中文,最后合成。
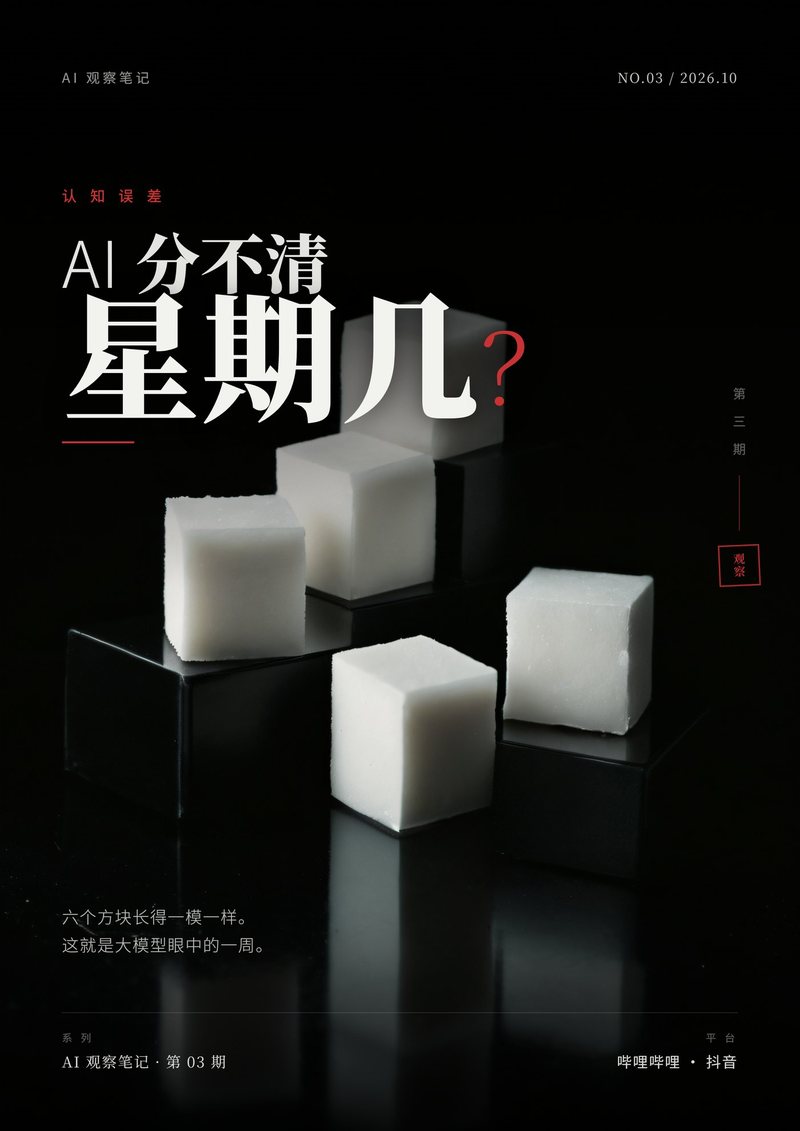 图 3|「AI 分不清星期几?」——底图 AI 生成,中文全部由 HTML 排版
- 收信息(标题、副标、时间地点、调性、素材、尺寸)
- 灰模定层级
- 生成底图(提示词里明确"不要任何文字,上方留白")
- HTML 排版(A4 300dpi = 2480×3508,四周 3mm 出血)
- 三验:眯眼、灰度、扫码
五、三条线共用的四件事
01|先验证,再批量
- 视频先出 15 秒样片,确认风格再跑全片
- 海报先出 1K 底图,构图满意再上 2K
- 文章先写小段落给方向,再展开全文
批量生产最贵的一次错误,就是方向错了还跑完了全程。
02|标准写成"技能"
每类工作都有一份自己的标准文档:怎么写分镜、怎么排版、怎么命名、交付要带什么。AI 每次开工前先读它,执行结果就稳定。
文档越写越厚,返工越来越少。
03|交付即成品
- 文章:正文 + 配图 + 目录 + 相关阅读,一次到位
- 视频:成片 + 封面 + 发布文案
- 海报:PNG + PDF + 可改字的源文件
“差一点就好了"不算交付。
04|用数字说话
时长、码率、响度、体积、构建时间、压缩率——这些数字比"感觉不错"可靠得多。每次做完记一笔,下次就有基准。
六、AI 做什么,人做什么
| AI | 人 | |
|---|---|---|
| 执行 | 排版、剪辑、转码、压图、生成 | — |
| 整理 | 资料、清单、命名、归档 | — |
| 判断 | — | 选题、审美、价值取向 |
| 兜底 | — | 事实核查、最终拍板 |
有些事目前还做不好:视频里的人物一致性、长内容的稳定性、以及"这个选题值不值得做”——这些仍然要人来盯。
小结
三条产线看起来是三件事,其实是同一套方法:
把标准写下来,把重复交出去,把判断留给自己。
工具会一直换,这套方法不会。