一次 16 秒的实验:目标不是做长片,而是验证「豆包生成 + 本地后期」这条线,能不能稳定产出一支可以直接发出去的竖屏短片。 成片规格:1080×1920 / 24fps / 16.2 秒 / 4 个镜头 + 2 张字卡 | 额外成本:¥0(豆包会员内)
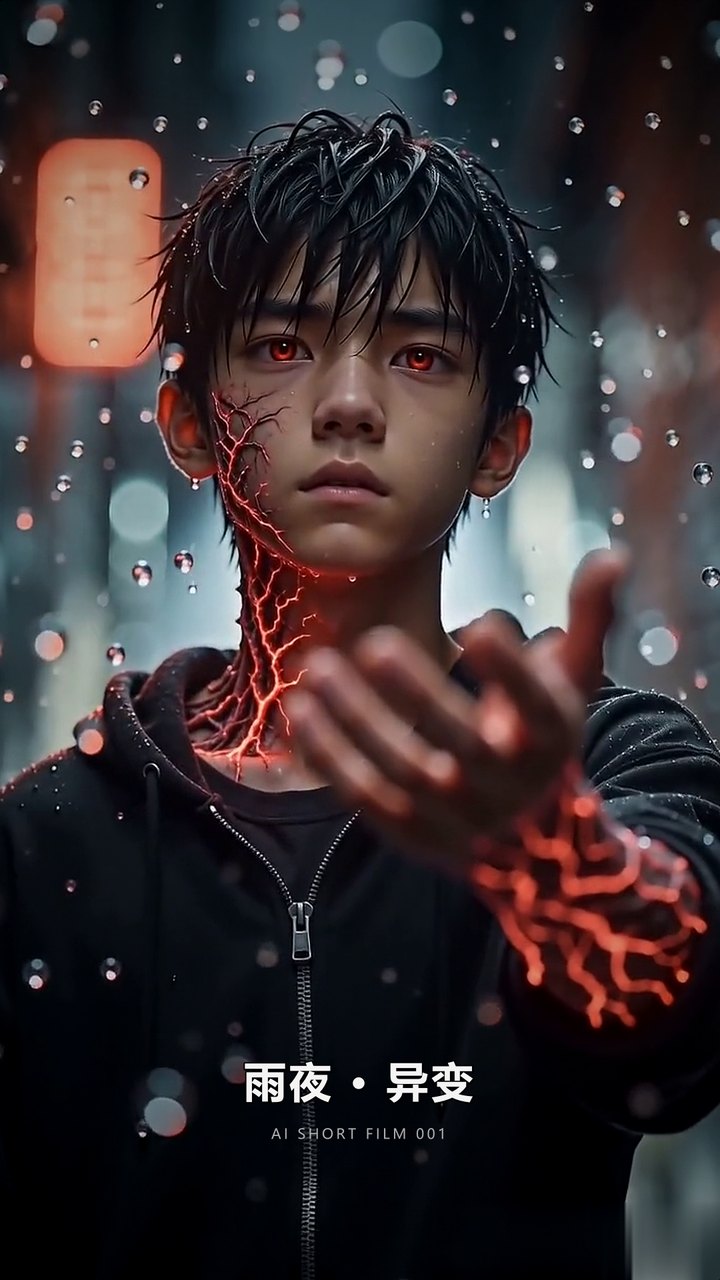 图 1|成片封面:「雨夜 · 异变 / AI SHORT FILM 001」
先说结论
- 短片成败不在「生成」那一下,而在镜头管理:4 个镜头各干一件事,比一条 20 秒的长镜头可控得多。
- 消费级视频模型的单条时长(5 秒左右)决定了工作方式:先多抽几版,再剪短用。
- 水印不是小事:豆包的水印在每条结尾淡入,规划镜头长度时就要先把它扣掉。
- 一致性是当前最大的短板:没有参考图,人物脸和服装会在镜头之间漂移。
一、这支片子长什么样
| 段落 | 内容 | 时长 |
|---|---|---|
| 标题卡 | 「雨夜 · 异变」+ AI SHORT FILM 001 | 1.8s |
| 镜 1 | 雨巷走入 | 3.4s |
| 镜 2 | 手臂红纹 | 2.5s |
| 镜 3 | 三个雨衣人 | 3.4s |
| 镜 4 | 红眼抬手,雨滴悬停 | 3.0s |
| 结尾卡 | 「未完待续」 | 2.1s |
四个镜头不是随机拼的,是一条最小的叙事链:环境 → 异常出现 → 威胁靠近 → 主角觉醒。
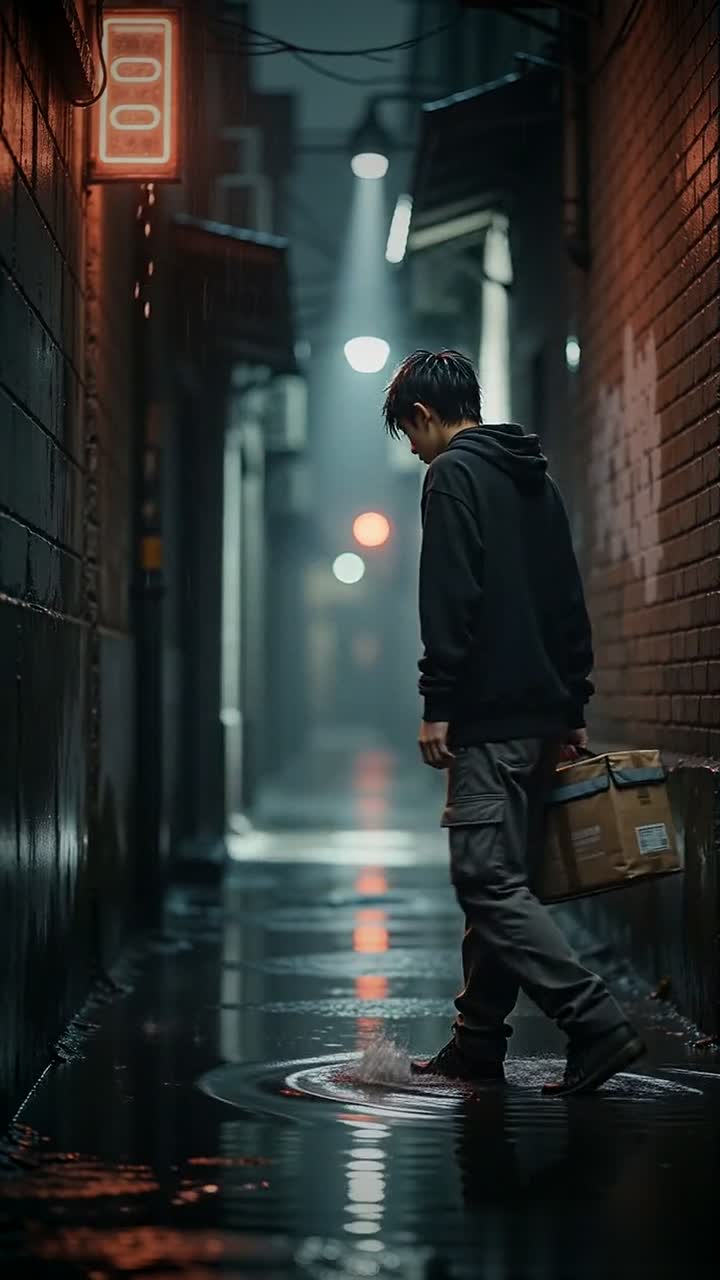 图 2|镜 1:雨巷走入——纸袋、积水和霓虹灯,先把"日常"立起来
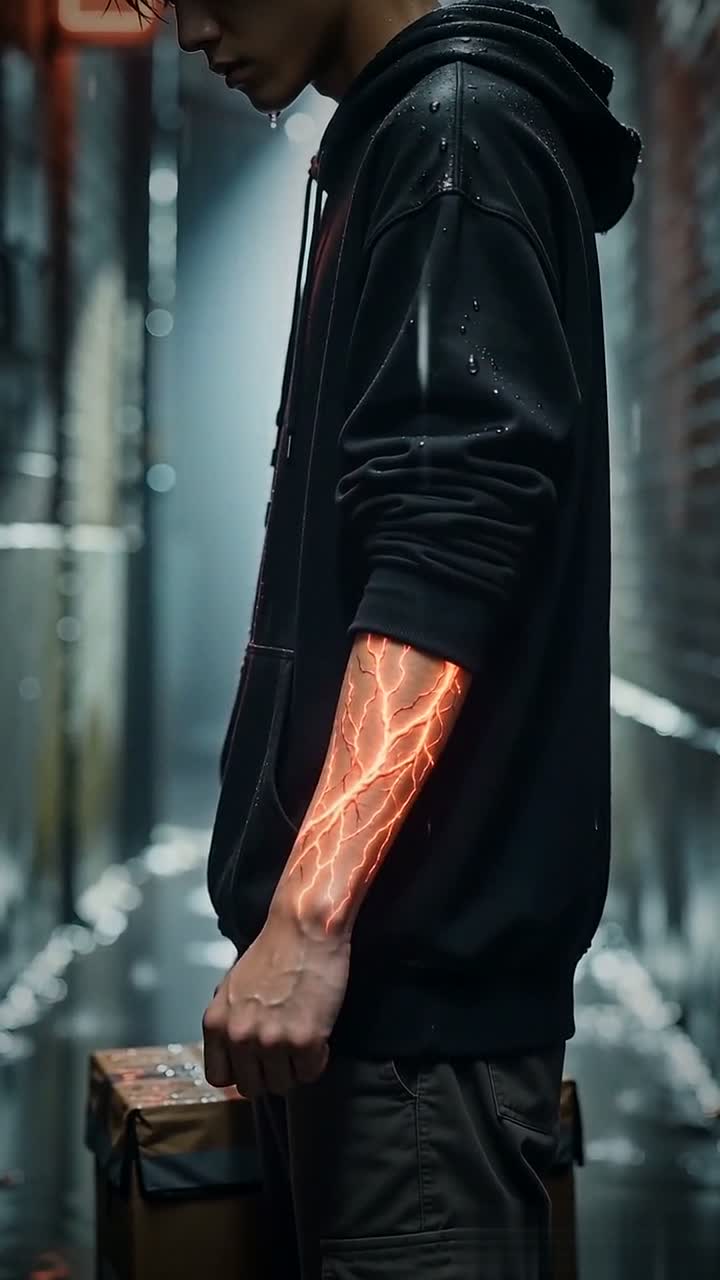 图 3|镜 2:手臂上的红色裂纹,第一个"异常"信号
二、分镜:一镜一动作
写分镜时只写三件事:谁、做什么、镜头怎么动。一个镜头只允许一个主要动作——两个动作叠在一起,生成结果通常会糊。
这一支的四个镜头分别是:
- 人从雨巷深处走向镜头(单一动作:走)
- 手臂特写,红色纹路亮起(单一动作:亮)
- 远景,三个雨衣人静止站立(单一动作:站)
- 抬手,雨滴悬停(单一动作:抬 + 一个环境反应)
经验:动作越简单,模型越稳。想让画面"有戏",靠剪辑和声音,不靠提示词堆料。
三、生成:豆包 Seedance 2.0
- 参数:720×1280 / 24fps / 每条 5.06 秒
- 每条提示词都带固定的风格句(雨夜、霓虹、电影感、浅景深)
- 每个镜头抽 2–3 版,挑最好的一版;同一提示词换 seed,结果差别很大
- 已知短板:各镜头独立生成,脸和服装会漂移——没有参考图就锁不住
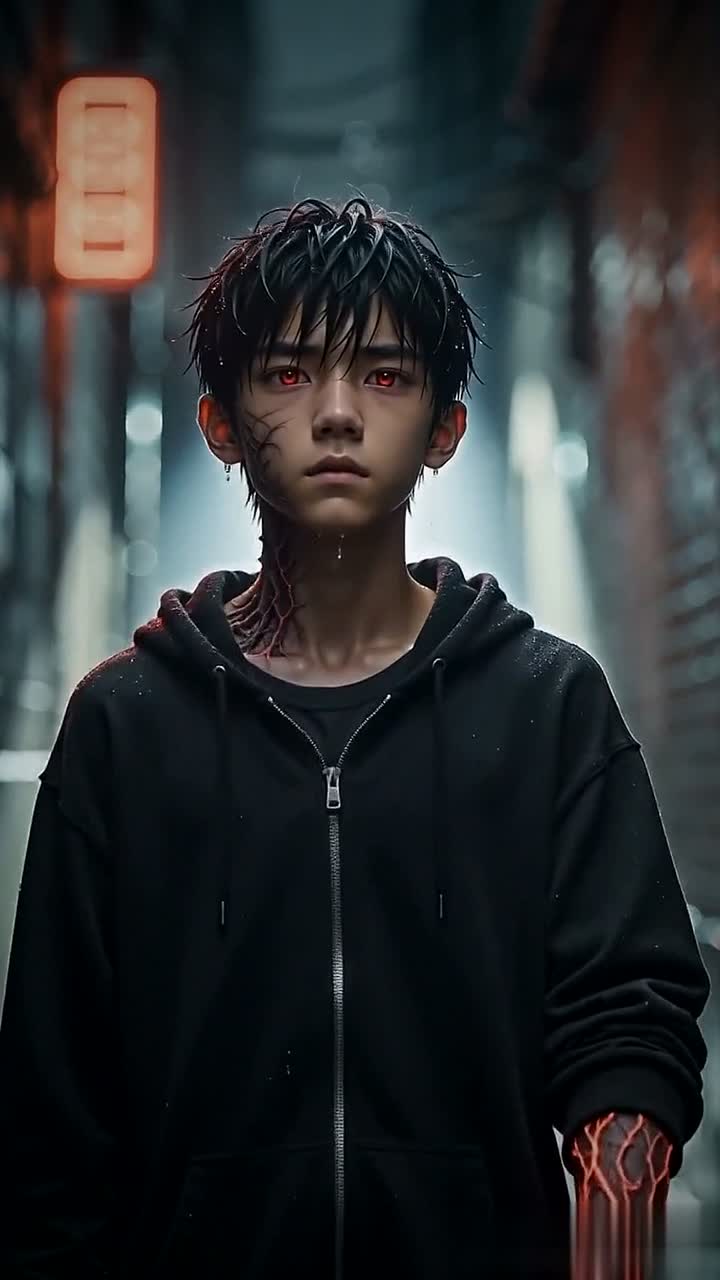 图 4|镜 4:红眼与红纹——同一角色,脸和衣服已经开始"漂"了
四、后期:ffmpeg 做的五件事
01|裁切
crop=690:1230:15:30
上下左右各留一点余量,顺手避开角落的水印区。
02|去水印
豆包的水印在每条结尾约 1 秒淡入(左下 / 左上),处理分两层:
- 生成时就按 4 秒规划镜头,把结尾那 1 秒直接剪掉;
- 边缘残留的部分,用
delogo抹掉(坐标按素材实测)。
03|拼接
用 trim + concat,不用 overlay 时间窗:
[0:v]trim=0:3.4,setpts=PTS-STARTPTS[v0];
[1:v]trim=0:2.5,setpts=PTS-STARTPTS[v1];
concat=n=6:v=1:a=0[v]
帧精确、一次重编码,也不会出现"素材全堆在开头"的经典翻车。
04|字卡
标题卡和结尾卡用 ASS 字幕:字体 Microsoft YaHei,白字 + 细描边,居中偏下。
05|混音
loudnorm=I=-16:TP=-1.5:LRA=11
原声 + BGM(Lightless Dawn,4–21 秒,音量 0.32),整体压到 -16 LUFS——发布平台比较安全的响度。
五、交付规格
| 项 | 母版 | 上传版 |
|---|---|---|
| 分辨率 | 1080×1920 | 1080×1920 |
| 帧率 | 24fps | 24fps |
| 编码 | CRF 18 | CRF 21 |
| 响度 | -16 LUFS | -16 LUFS |
| 体积 | 43 MB | 19 MB |
| 时长 | 16.2s | 16.2s |
六、和长视频线有什么不同
我的长视频线(3–5 分钟的 AI 科普)走的是另一套:
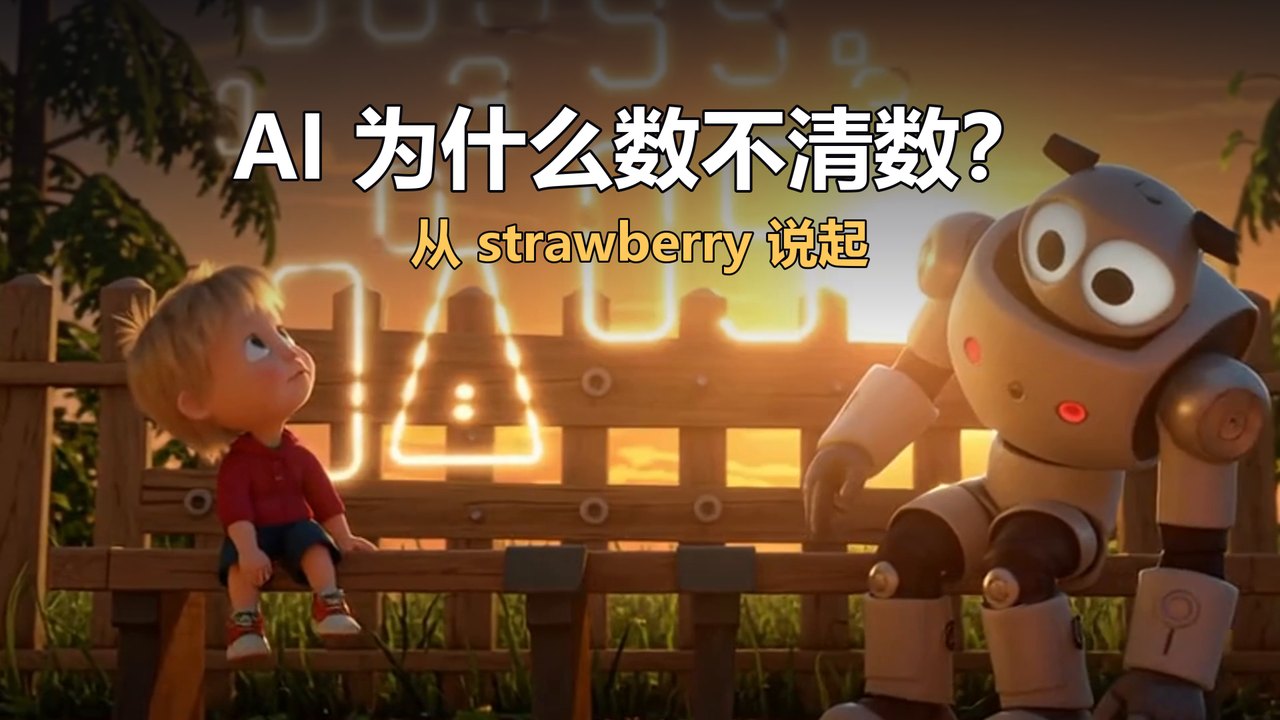 图 5|长视频一期封面:《AI 为什么数不清数?从 strawberry 说起》——封面文字同样是后期叠上去的
 图 6|长视频用本地生成的镜头 + 逐句字幕(Whisper 词级对齐)
| 长视频(3–5 分钟) | 短视频(15–30 秒) | |
|---|---|---|
| 画面 | 本地 LTX / ComfyUI,8–10 个镜头 | 豆包 Seedance,4–8 个镜头 |
| 声音 | edge-tts 配音 + 音效 + BGM | 原声 + BGM,无旁白 |
| 字幕 | Whisper 词级对齐,逐句上屏 | 字卡(标题 / 结尾) |
| 引擎 | Hyperframes 动效 + ffmpeg | 纯 ffmpeg 剪辑 |
七、这一支学到的四件事
- 一致性靠参考图:下一步用首尾帧 / 参考图锁人物,而不是靠提示词"描述得更细"。
- 5 秒是硬约束:所有叙事节奏都按"5 秒一段"设计,再剪到 2.5–3.5 秒用。
- 水印要提前算:生成时就知道结尾 1 秒不能用,镜头长度按 4 秒规划。
- 声音决定"片感":同样的画面,加上 BGM 和响度处理后,观感差别非常大。
小结
这支 16 秒的片子证明了一件事:能刷到的"AI 短片感",一半来自生成,一半来自剪辑和声音。模型给的是素材,节奏、字卡、混音才是作品。
下一步:用参考图锁住人物,再拍一支 30 秒、有对白的版本。